Imagine a rescue mission in a large, unstructured area: you need to cover ground fast, find anyone who might be lying there, and get help to them quickly. Now imagine doing all of that with a single person giving voice commands to a whole team of drones and one ground robot — no joysticks, no programming, no control room full of specialists. That is the vision behind our latest work, One Operator, Many Robots: Natural-Language Command of UAV–UGV Teams for Search, Victim Detection, and Rescue, accepted at IEEE SSRR 2026. It builds directly on Swarm-Steward and takes it one crucial step further: connecting what the drones see with what the ground robot does.Imagina una misión de rescate en un área grande y desestructurada: hay que cubrir terreno rápido, encontrar a quien pueda estar allí tirado, y llegar con ayuda cuanto antes. Ahora imagina hacer todo eso con una sola persona dando órdenes por voz a un equipo entero de drones y un robot terrestre — sin joysticks, sin programación, sin una sala de control llena de especialistas. Esa es la visión de nuestro último trabajo, One Operator, Many Robots: Natural-Language Command of UAV–UGV Teams for Search, Victim Detection, and Rescue, aceptado en IEEE SSRR 2026. Se apoya directamente en Swarm-Steward y da un paso crucial más: conectar lo que los drones ven con lo que el robot terrestre hace.
Figure 1 shows the end-to-end workflow demonstrated in the field: (a) natural-language mission control, (b) multi-UAV aerial search and victim localization, and (c) UGV deployment toward the confirmed victim location.La Figura 1 muestra el flujo de trabajo completo demostrado en campo: (a) control de misión por lenguaje natural, (b) búsqueda aérea multi-UAV y localización de víctimas, y (c) despliegue del UGV hacia la ubicación confirmada de la víctima.
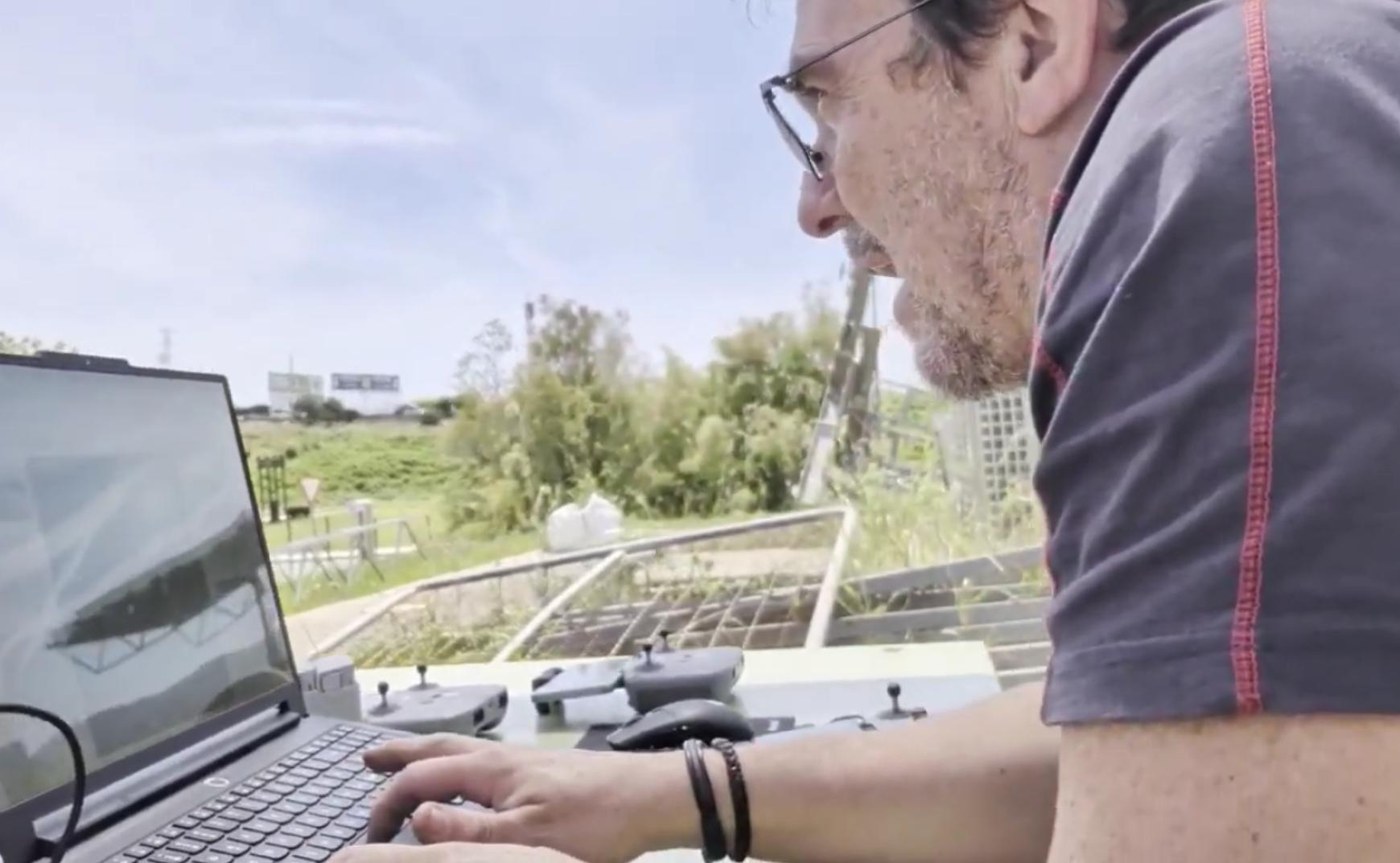
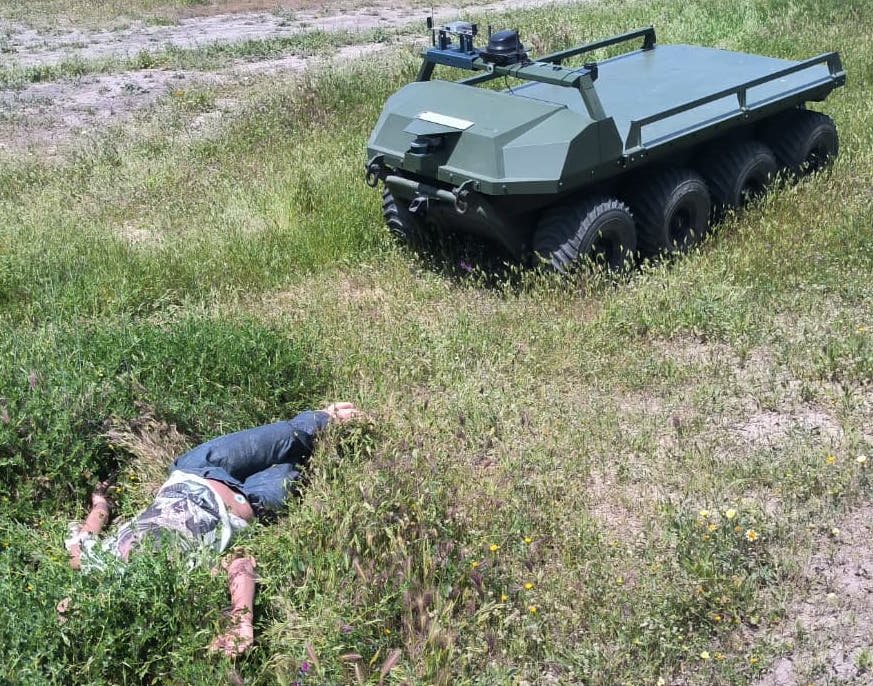
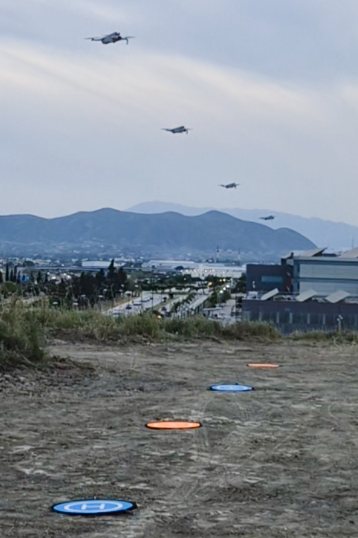
From aerial search to ground responseDe la búsqueda aérea a la respuesta terrestre
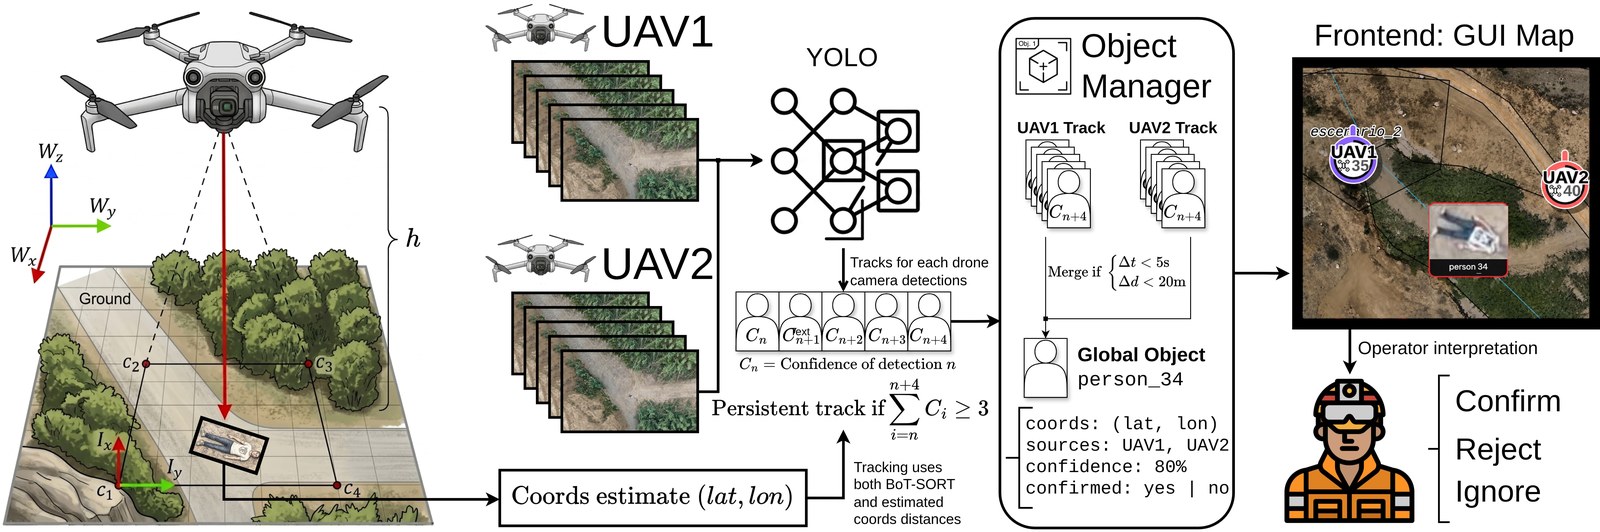
Search-and-rescue operations require rapid area coverage, reliable victim localization, and fast deployment of response assets — but connecting aerial perception with ground-robot action remains difficult for non-expert operators. During autonomous lawnmower-style search, DJI Mini 4 Pro UAVs stream video and telemetry to a perception pipeline that applies a YOLO26l aerial person detector, tracks detections over time, and projects candidate victims to ground coordinates using UAV pose, gimbal state, camera geometry, and terrain elevation.Las operaciones de búsqueda y rescate requieren cobertura rápida del área, localización fiable de víctimas y despliegue veloz de los recursos de respuesta — pero conectar la percepción aérea con la acción del robot terrestre sigue siendo difícil para operadores no expertos. Durante la búsqueda autónoma en barrido, los DJI Mini 4 Pro transmiten vídeo y telemetría a un pipeline de percepción que aplica un detector de personas aéreas YOLO26l, sigue las detecciones en el tiempo y proyecta las víctimas candidatas a coordenadas de suelo usando la pose del UAV, el estado del gimbal, la geometría de cámara y la elevación del terreno.
Figure 2 shows the full victim-detection and cross-UAV association pipeline: detections in sampled frames are geolocated from telemetry and terrain elevation, accumulated into per-UAV tracks, associated across UAVs by the Object Manager, and surfaced to the operator as candidate objects that can be confirmed, rejected, or allowed to expire.La Figura 2 muestra el pipeline completo de detección y asociación cross-UAV: las detecciones en frames muestreados se geolocalizan con telemetría y elevación del terreno, se acumulan en tracks por UAV, se asocian entre UAVs mediante el Object Manager, y se presentan al operador como objetos candidatos que pueden confirmarse, rechazarse o dejar expirar.
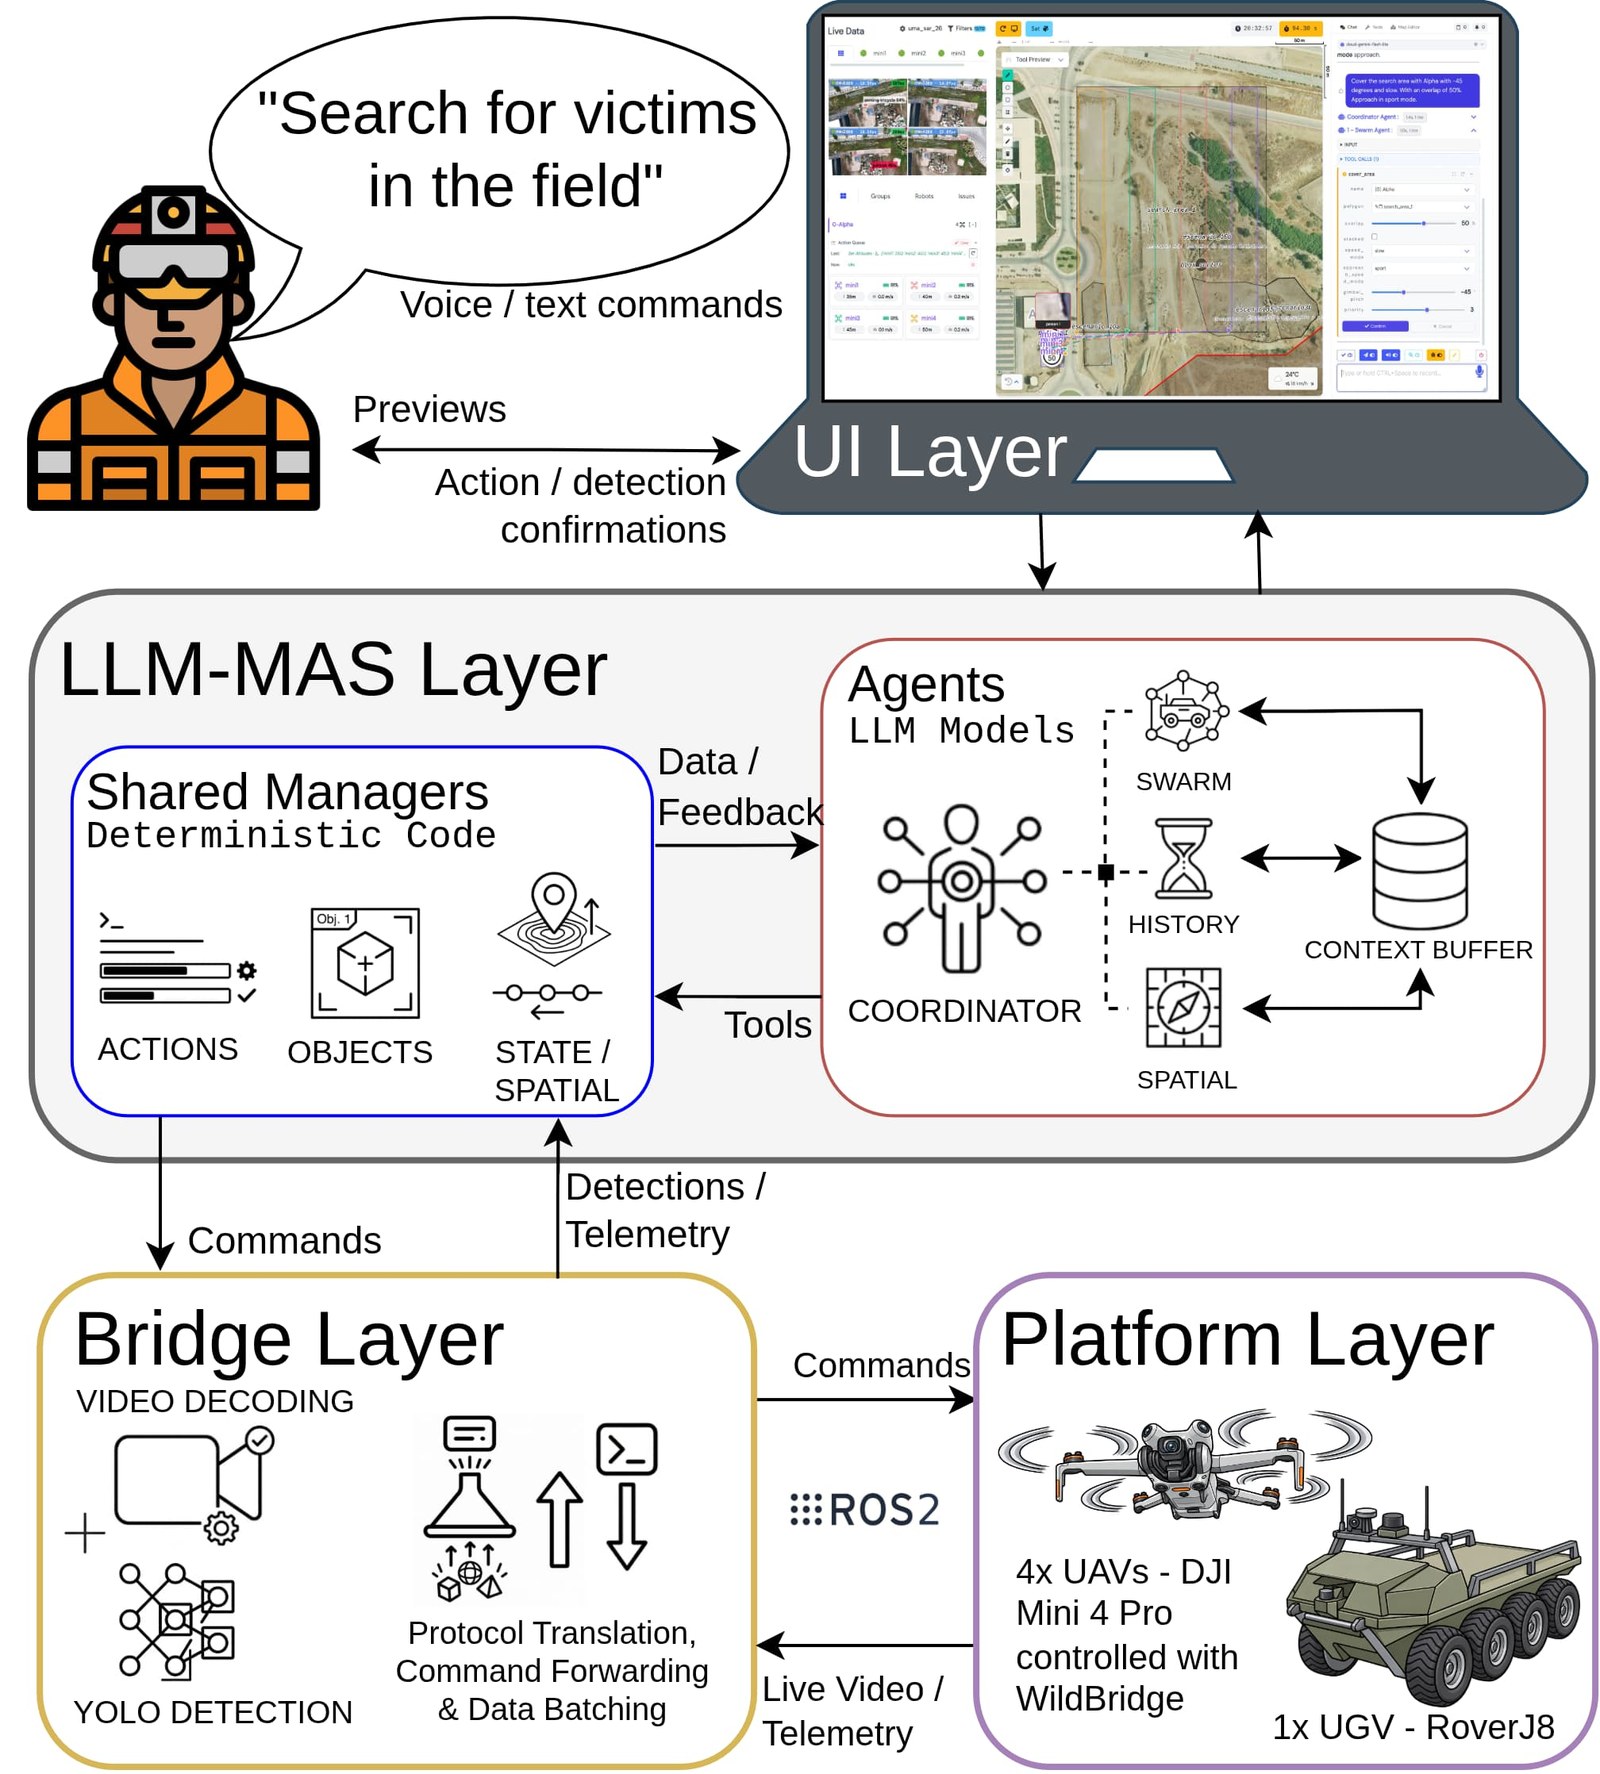
Accepted tracks are surfaced on the mission map as dynamic entities that the operator can confirm or reject — and once confirmed, they can be referenced in follow-up natural-language commands, for example to send a UAV to monitor the victim or to dispatch the UGV toward a nearby rescue position. Figure 3 shows the extended architecture: the UI layer supports natural-language commands, previews, and confirmations; the LLM-MAS layer coordinates agents and deterministic managers; the bridge layer performs protocol translation, video decoding, detection, and data batching; and the platform layer contains the UAV and UGV robots.Los tracks aceptados aparecen en el mapa de misión como entidades dinámicas que el operador puede confirmar o rechazar — y una vez confirmados, pueden referenciarse en comandos de lenguaje natural posteriores, por ejemplo para enviar un UAV a vigilar a la víctima o despachar el UGV hacia una posición de rescate cercana. La Figura 3 muestra la arquitectura extendida: la capa de UI soporta comandos de lenguaje natural, previsualizaciones y confirmaciones; la capa LLM-MAS coordina agentes y managers deterministas; la capa bridge hace la traducción de protocolos, decodificación de vídeo, detección y batching de datos; y la capa de plataforma contiene los robots UAV y UGV.
Training the aerial person detectorEntrenando el detector de personas aéreas
Because aerial person detection at these altitudes is different from ground-level detection, we trained a custom YOLO26l model on a merged set of four aerial-person datasets — SARD, HERIDAL, LaDD, and NOMAD — summarized in Table 1.Como la detección de personas aérea a estas altitudes difiere de la detección a nivel de suelo, entrenamos un modelo YOLO26l propio sobre una fusión de cuatro datasets de personas aéreas — SARD, HERIDAL, LaDD y NOMAD — resumidos en la Tabla 1.
| Dataset | Orig. imgs | Used | Val. imgs | Selection / preprocessing |
|---|---|---|---|---|
| SARD | 1,183 | 1,000 | 200 | Person-like classes collapsed to person; largest avg bbox area preferred |
| HERIDAL | 1,546 | ~985 | 197 | CSV labels converted to YOLO; largest avg bbox area preferred |
| LaDD | 1,220 | 1,000 | 200 | COCO labels converted to YOLO; largest avg bbox area preferred |
| NOMAD | 20,752 | 1,000 | 200 | Altitude-stratified 10/30/50 m sampling with round-robin actor selection |
Four aerial-person datasets merged and relabeled to a common person class (~4,000 training images).
Table 2 shows the retrospective model sweep on the balanced validation split. YOLO26l achieved the best mAP50–95 = 0.501 (mAP50 = 0.832) while avoiding the larger checkpoint of YOLO26x. Inference runs on the ground station (RTX 5090), so throughput was never the bottleneck in the field.La Tabla 2 muestra el barrido retrospectivo de modelos sobre la partición de validación balanceada. YOLO26l logró el mejor mAP50–95 = 0,501 (mAP50 = 0,832) evitando el checkpoint mayor del YOLO26x. La inferencia corre en la ground station (RTX 5090), así que el throughput nunca fue el cuello de botella en campo.
| Model | mAP50 | mAP50–95 | Inference (ms/image) | Checkpoint (MiB) |
|---|---|---|---|---|
| YOLO26n | 0.774 | 0.412 | 1.91 | 5.1 |
| YOLO26s | 0.823 | 0.467 | 2.04 | 19.4 |
| YOLO26m | 0.819 | 0.487 | 3.92 | 42.0 |
| YOLO26l (chosen) | 0.832 | 0.501 | 4.48 | 50.5 |
| YOLO26x | 0.814 | 0.500 | 8.95 | 112.8 |
YOLO26l selected: best mAP50–95 (0.501) while retaining stronger recall than YOLO26x and a much smaller checkpoint. Inference time is the image-weighted mean over the source-validation runs on the ground-station laptop (NVIDIA RTX 5090), excluding preprocessing, video transport, and tracking.
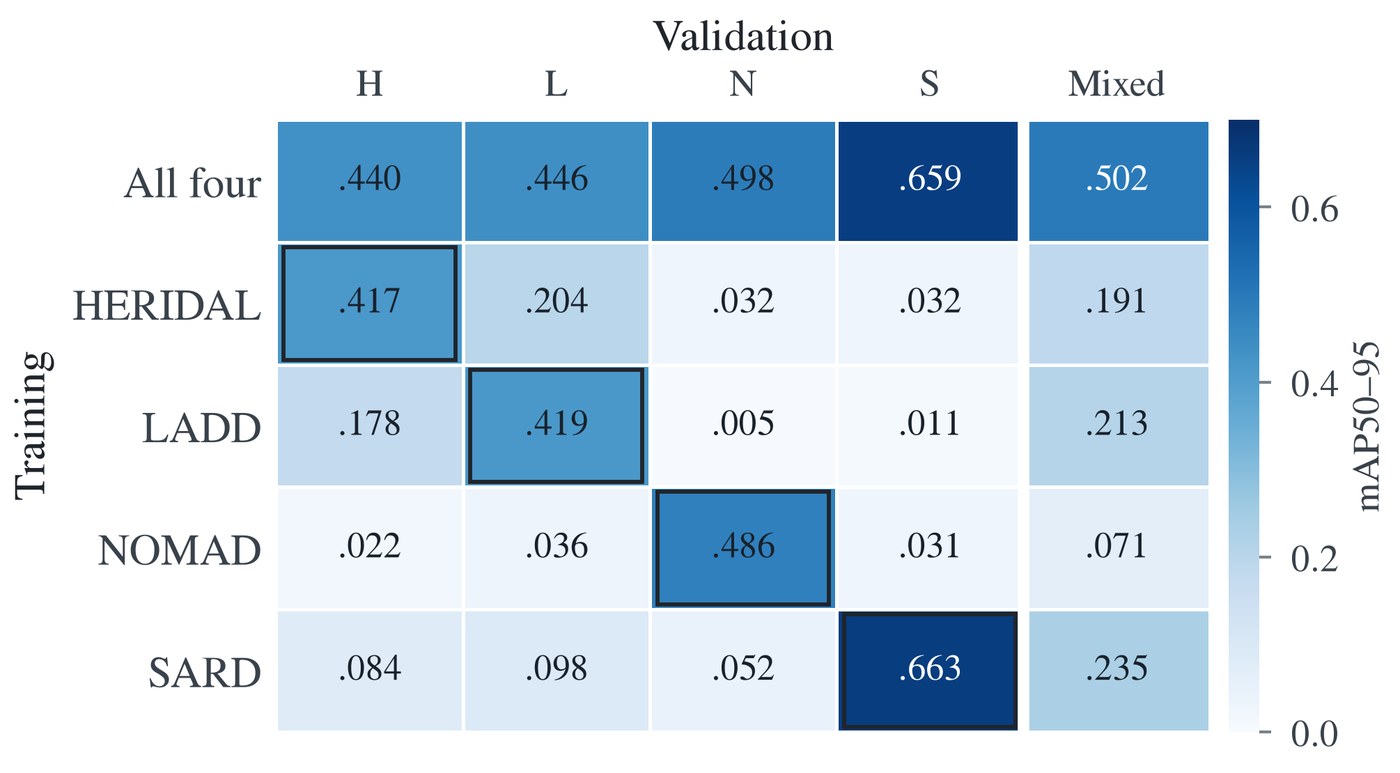
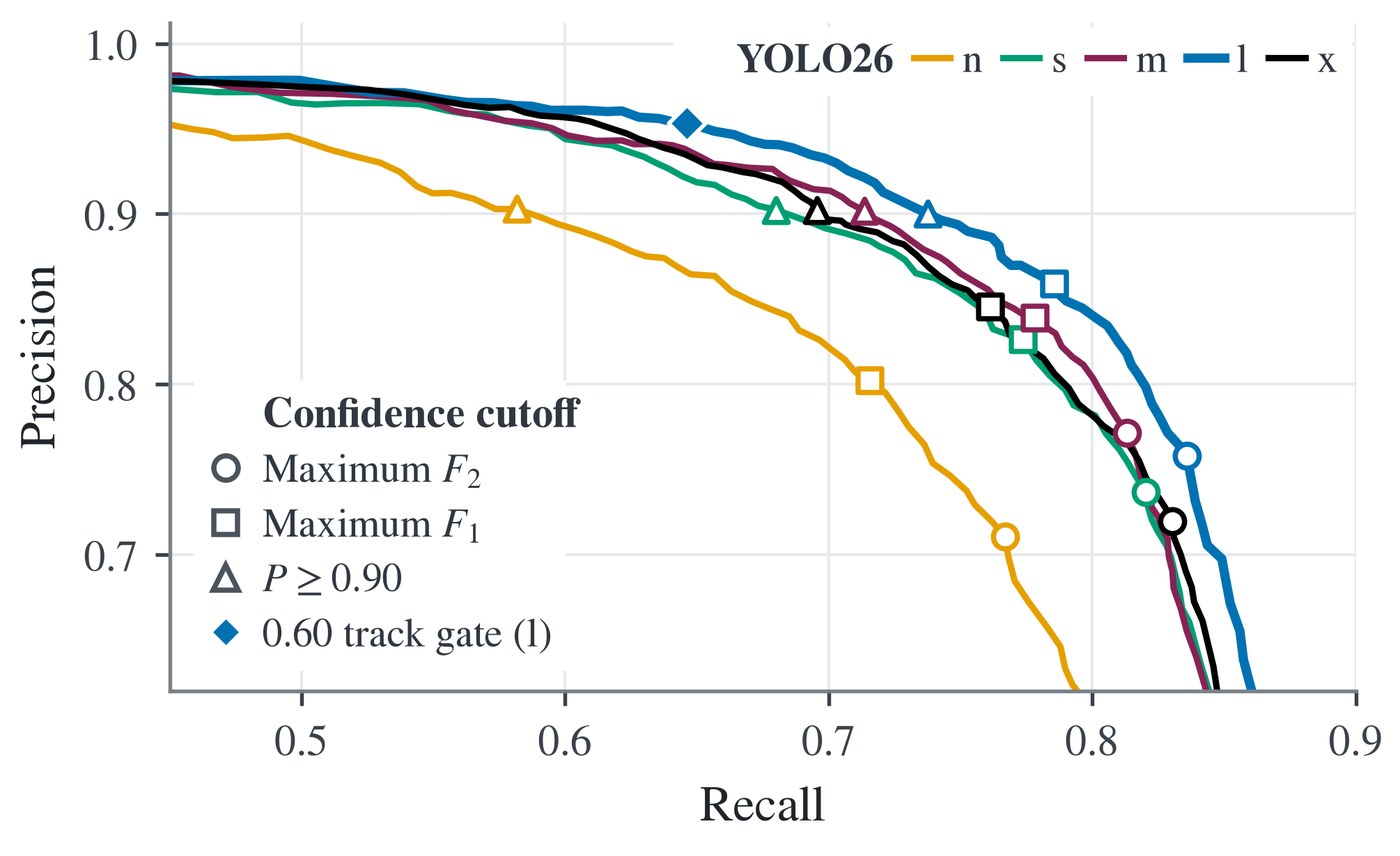
The camera-ready version adds two detector analyses: how the combined model compares against single-dataset specialists, and where the detector's precision–recall operating points land for each model size.La versión camera-ready añade dos análisis del detector: cómo se compara el modelo combinado frente a especialistas de un solo dataset, y dónde caen los puntos de operación precisión-recall de cada tamaño de modelo.
Twelve outdoor experimentsDoce experimentos en exteriores
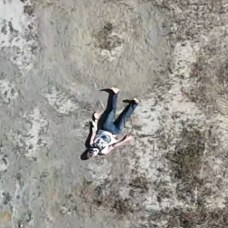
We evaluated the system in 12 outdoor experiments over an approximately 48,000 m² unstructured area, covering four victim placements, one-, two-, and four-UAV teams, different gimbal angles, and search speeds. Figure 4 shows the search area, the planned lawnmower sweeps, and drone-view examples of the four victim placements (a–d), with the full search area and sweep plan below.Evaluamos el sistema en 12 experimentos en exteriores sobre un área desestructurada de unos 48.000 m², cubriendo cuatro colocaciones de víctima, equipos de uno, dos y cuatro UAVs, distintos ángulos de gimbal y velocidades de búsqueda. La Figura 4 muestra el área de búsqueda, los barridos planeados y ejemplos desde el dron de las cuatro colocaciones de víctima (a–d), con el área completa y el plan de barrido debajo.
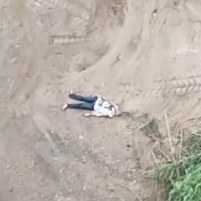
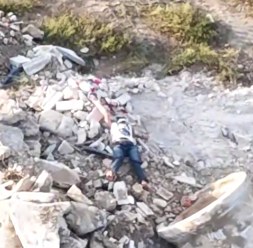
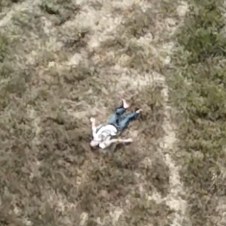
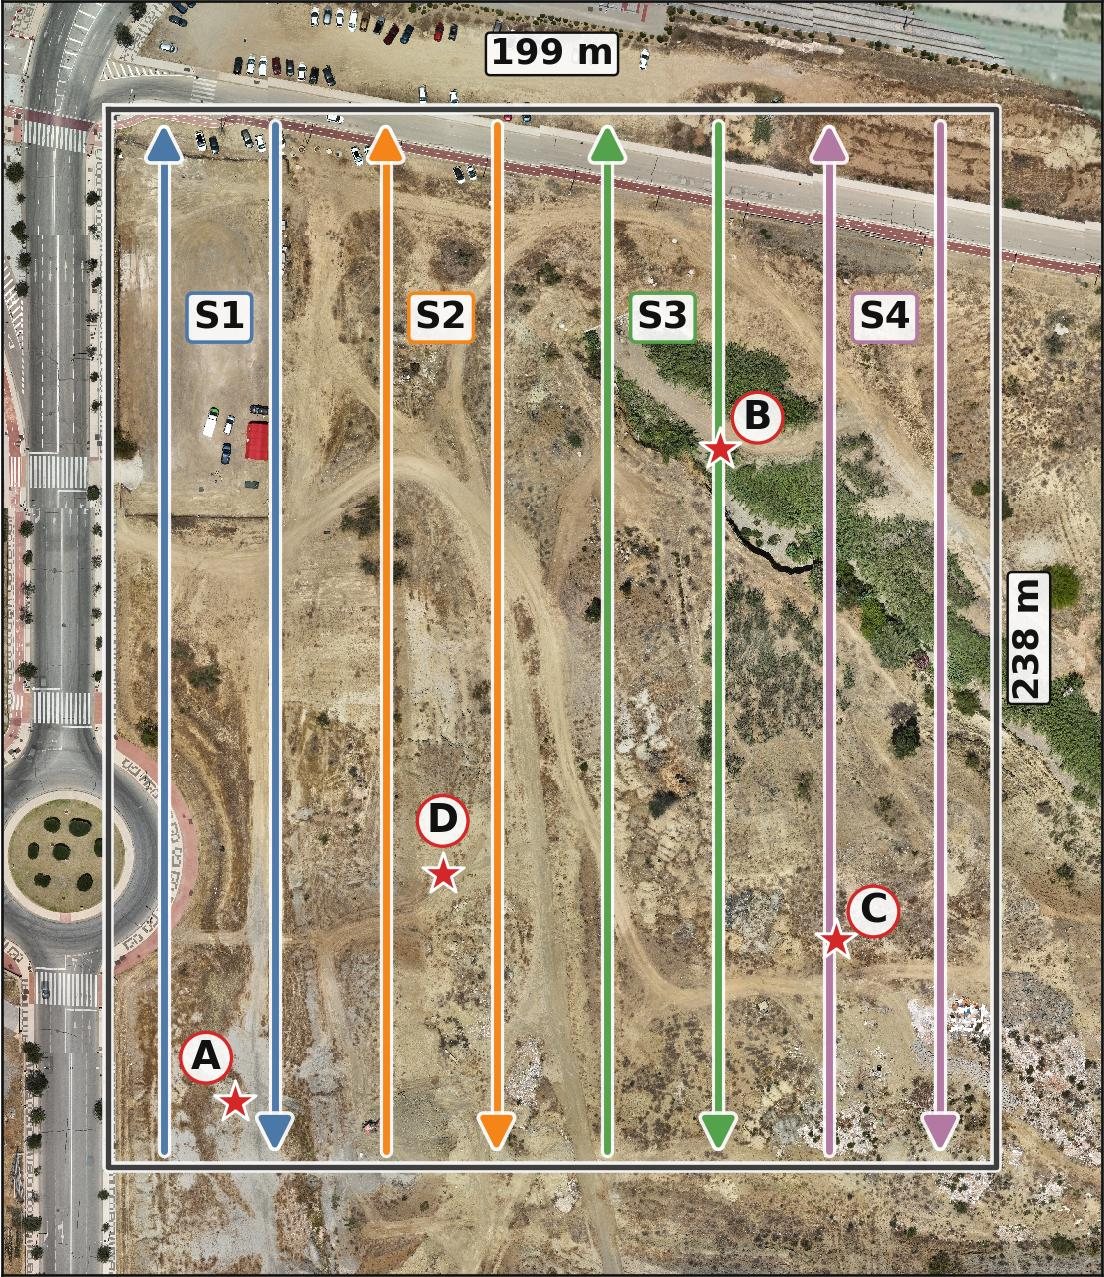
Three placements produced successful detections with best mean localization errors of 1.21 m, 2.29 m, and 1.92 m; the fourth placement (location C) remained unresolved. Table 3 reports the representative outcomes per scenario.Tres colocaciones produjeron detecciones exitosas con errores medios de localización más bajos, de 1,21 m, 2,29 m y 1,92 m; la cuarta colocación (ubicación C) no llegó a resolverse. La Tabla 3 recoge los resultados representativos por escenario.
| Scenario (Loc./N) | Speed (m/s) | Gimbal | Detector | Alt. (m) | Track det. | Mean err. (m) | Mean conf. |
|---|---|---|---|---|---|---|---|
| A / 1 | 2 | −90° | mini4 | 35 | 18 | 1.21 ± 0.58 | 0.67 ± 0.18 |
| A / 2 | 2 | −90° | mini2 | 40 | 50 | 1.99 ± 0.78 | 0.52 ± 0.12 |
| A / 4 | 2 | −90° | mini3 | 45 | 15 | 2.41 ± 0.51 | 0.73 ± 0.11 |
| B / 1 | 4 | −45° | mini4 | 35 | 38 | 8.80 ± 1.46 | 0.74 ± 0.14 |
| B / 2 | 4 | −45° | mini2 | 40 | 10 | 7.09 ± 1.25 | 0.60 ± 0.14 |
| B / 4 | 2 | −90° | mini2 | 40 | 34 | 2.29 ± 0.29 | 0.67 ± 0.14 |
| C / 4 | 4 | −90° | — | — | — | — | — |
| C / 4 | 4 | −45° | — | — | — | — | — |
| D / 1 | 4 | −45° | mini1 | 35 | 17 | 9.33 ± 0.56 | 0.66 ± 0.13 |
| D / 2 | 4 | −45° | mini2 | 40 | 12 | 3.13 ± 0.76 | 0.65 ± 0.16 |
| D / 4 | 4 | −45° | mini3 | 45 | 9 | 1.92 ± 0.06 | 0.47 ± 0.14 |
| D / 1 | 4 | −90° | mini1 | 80 | 47 | 6.37 ± 2.85 | 0.66 ± 0.13 |
Locations A, B, D localized within 10 m; location C (difficult placement) was not localized. A / 1 and B / 1 at 35 m used mini4; D / 1 at 80 m used mini1.
From detection to rescue responseDe la detección a la respuesta de rescate
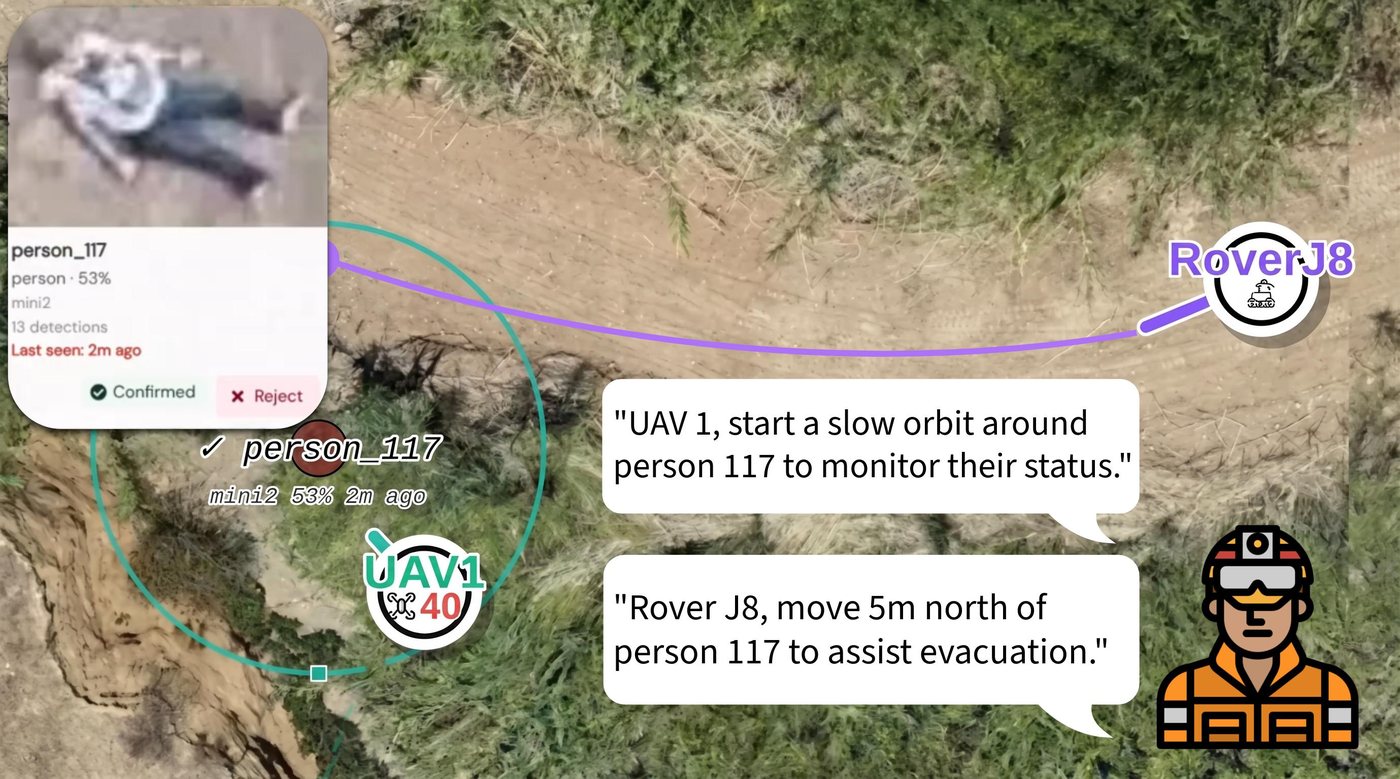
Once the operator confirms a candidate, the victim becomes a shared mission target that can be referenced in follow-up natural-language commands — for example, commanding a UAV to orbit the victim for continued monitoring while the UGV is dispatched to a position 5 m north to assist with evacuation without driving directly over the person. Figure 5 shows this post-detection response.Una vez el operador confirma un candidato, la víctima se convierte en un objetivo de misión compartido que puede referenciarse en comandos de lenguaje natural posteriores — por ejemplo, ordenar a un UAV orbitar a la víctima para vigilancia continua mientras el UGV se despacha a una posición 5 m al norte para asistir en la evacuación sin pasar por encima de la persona. La Figura 5 muestra esta respuesta post-detección.
Feedback from a professional firefighterOpinión de un bombero profesional
A professional firefighter from Benalmádena (Málaga) joined the field demonstration and gave direct operational feedback, supporting the relevance of sector-based search, persistent no-go areas, human confirmation, and emergency pause and return commands that bypass the language model for SAR-oriented multi-robot deployment.Un bombero profesional de Benalmádena (Málaga) se unió a la demostración de campo y dio feedback operativo directo, apoyando la relevancia de la búsqueda por sectores, las áreas de no-paso persistentes, la confirmación humana y los comandos de pausa de emergencia y retorno que omiten el modelo de lenguaje para el despliegue multi-robot orientado a SAR.
A. Jarabo-Peñas, J. Bravo-Arrabal, E.G.A. Rolland, A.L. Christensen. Accepted at IEEE SSRR 2026. Supported by the Independent Research Fund Denmark (grant 4264-00105B, NAMUR project). Also on the NAMUR site.A. Jarabo-Peñas, J. Bravo-Arrabal, E.G.A. Rolland, A.L. Christensen. Aceptado en IEEE SSRR 2026. Financiado por el Independent Research Fund Denmark (grant 4264-00105B, proyecto NAMUR). También en la web de NAMUR.
📖 Related: Swarm-Steward (IEEE ICUAS 2026) · Voice-Commanded UGV for SAR Logistics (IEEE SSRR 2025)📖 Relacionados: Swarm-Steward (IEEE ICUAS 2026) · UGV con comandos de voz para logística SAR (IEEE SSRR 2025)